

Come l'AI cambia la sicurezza informatica: il caso Block
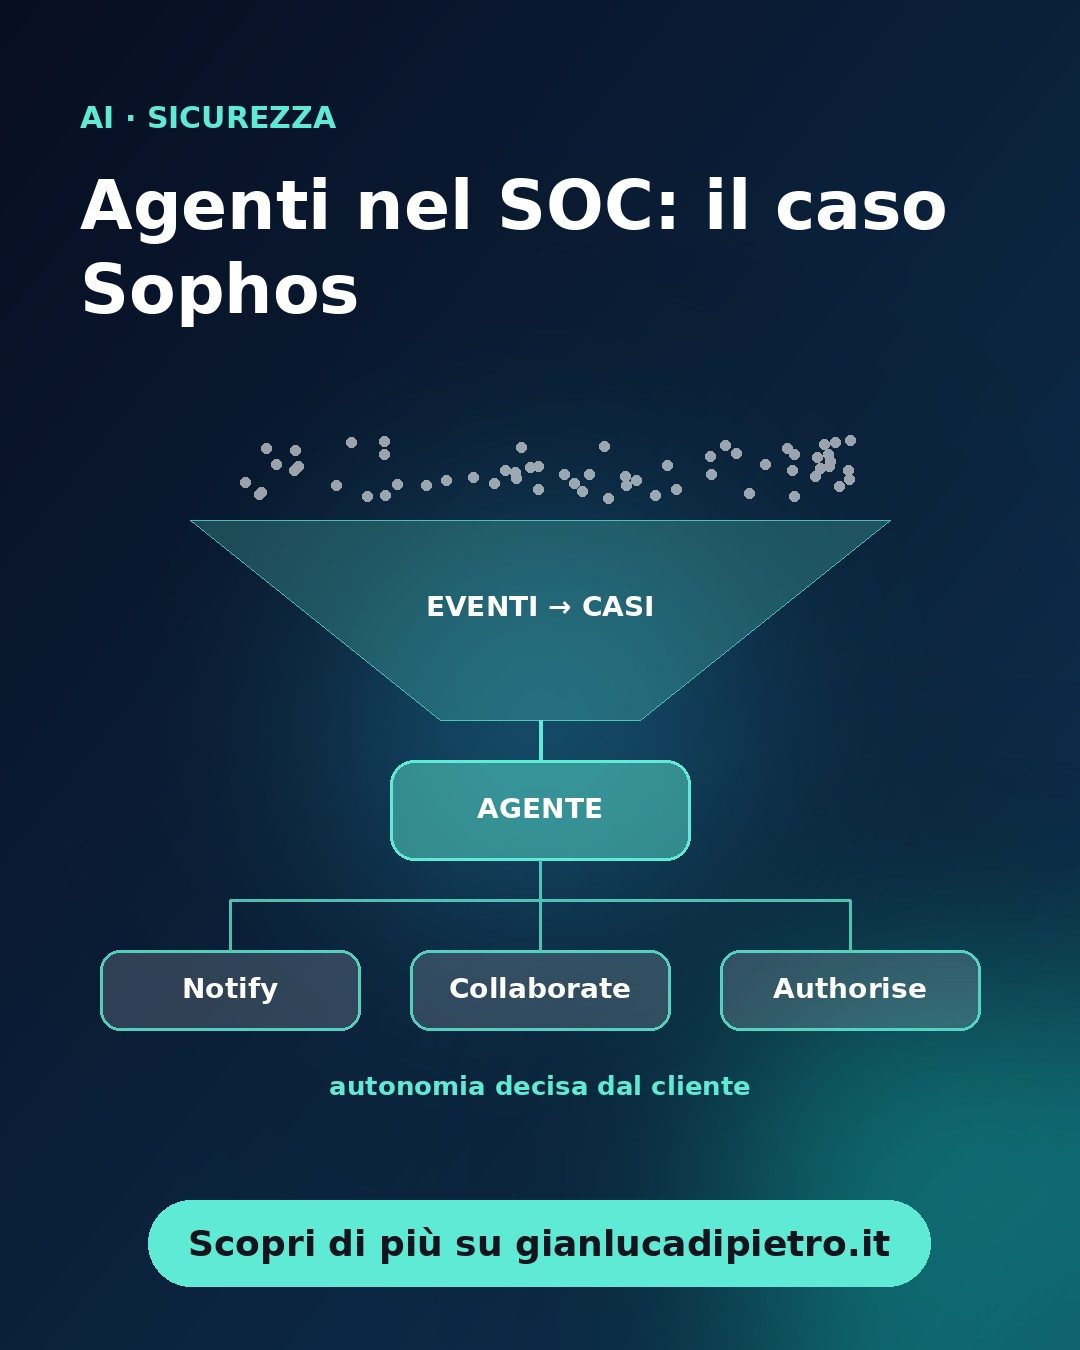
Quando si parla di intelligenza artificiale nella sicurezza informatica, il pensiero più comune è quello di un assistente che risponde alle domande del SOC. Il caso che OpenAI ha pubblicato su Block racconta un'altra cosa: un sistema di agenti inserito nel flusso reale di rilevamento, investigazione e correzione. È un caso di studio scritto dal fornitore e dal cliente, quindi va letto con cautela, ma contiene indicazioni pratiche utili anche per chi gestisce infrastrutture molto più piccole.
## Dove si perde tempo nella sicurezza
Chi lavora in un team di sicurezza conosce il problema: la maggior parte delle ore non va in decisioni difficili, ma in lavoro ripetitivo. Falsi positivi da chiudere, log da correlare, regole di detection da rieseguire su dati vecchi. Nel caso Block, il sistema ha restituito circa 600 ore-analista per trimestre sottratte ai falsi positivi e ha completato circa 1.100 ore di investigazione nello stesso periodo. Il throughput del triage dichiarato cresce del 50%.
Un dato spiega bene dove sta il valore. Il tuning delle regole di detection, che prima richiedeva di rilanciare a mano centinaia di casi storici, oggi si esegue in meno di un'ora su sette mesi di telemetria di produzione. Non è un miglioramento del modello in sé: è la possibilità di ripetere un esperimento in fretta. Chi ha mai tenuto in piedi uno script di test su log storici sa quanto conti questa differenza.
## Un harness sopra il modello
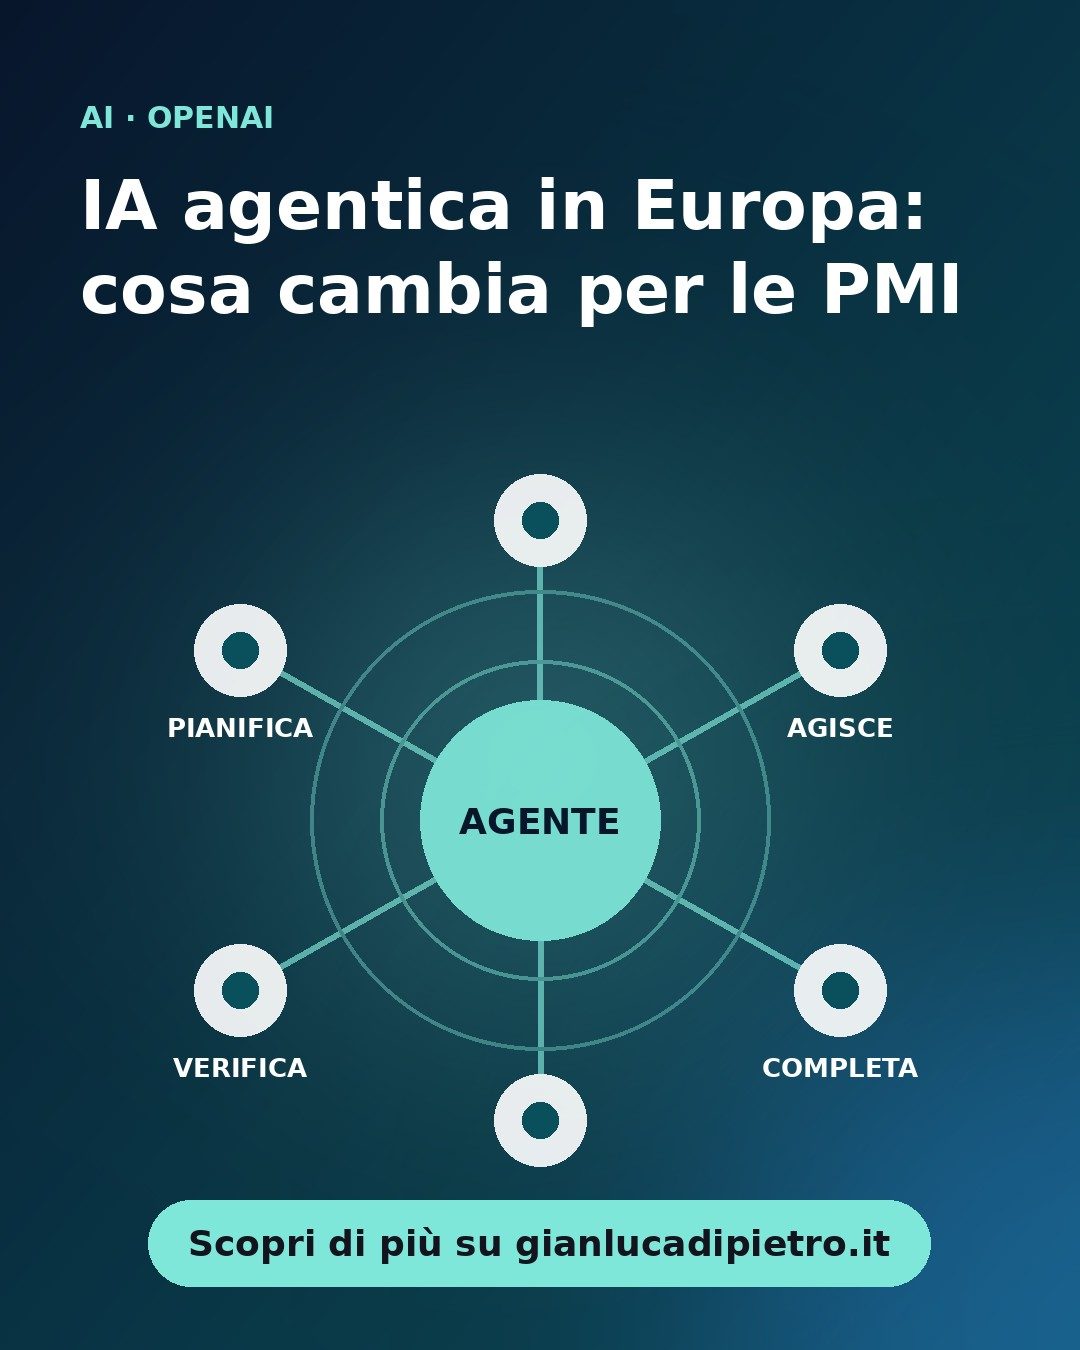
L'architettura descritta è più interessante dei numeri. Sopra la piattaforma Daybreak c'è un harness che instrada i task verso il modello più adatto. Il team ha imparato che non serve sempre il modello più recente: costi e latenza possono variare molto, e per molti compiti un modello più leggero basta.
Attorno all'harness ci sono tre meccanismi che ricorrono in ogni sistema affidabile. C'è un punto di intervento umano, che permette a una persona di prendere in carico un task in qualsiasi momento. C'è una verifica incrociata, in cui un agente controlla il lavoro di un altro. E c'è una valutazione continua su benchmark interni e su risultati reali, con instradamento verso la revisione umana quando l'incertezza è alta. Il dettaglio più utile è forse un altro: le evidenze grezze di ogni query vengono conservate, così che una modifica si possa riprodurre e testare su dati storici.
## Dalla segnalazione alla patch
Nell'articolo si parla anche di remediation. Nelle recenti esercitazioni red team, il tempo dalla segnalazione di una vulnerabilità ad alto livello a una patch proposta automaticamente è stato di 18 minuti. Una catena completa di attacco (SQL injection, escalation dei privilegi, enumerazione delle credenziali, pivot su altri sistemi) è stata eseguita in circa due ore, a fronte di giorni per un red teamer umano.
Il processo che descrivono è forse la parte più importante: individuare il codice e il suo proprietario, proporre la patch, confermare che la vulnerabilità sia sfruttabile, verificare che la correzione funzioni, e lasciare a una persona la guida e il deploy. L'autonomia cresce man mano che l'affidabilità si dimostra nel tempo, non per decreto.
## Il segnale nascosto tra due prodotti
Il caso più istruttivo è semplice da raccontare. Un alert su un singolo laptop sembrava un problema di policy minore. Durante la peer review, il modello ha seguito un indicatore presente solo di sfuggita nelle evidenze, lo ha incrociato con i log di identità e ha rivelato una campagna più ampia. Il segnale esisteva solo unendo i log di due prodotti diversi.
È un pattern che vale anche in una PMI: i dati stanno in strumenti diversi (firewall, EDR, directory, posta) e nessuno li guarda insieme. Un agente che può leggere più fonti trova correlazioni che un analista, con una coda di alert da smaltire, difficilmente cerca.
## Cosa non dice l'articolo
Le cifre sono autodichiarate e non verificate in modo indipendente. Non ci sono metodologia, baseline né campione. Il tempo di 18 minuti riguarda esercitazioni, non incidenti reali. Va letto come indicazione di potenziale, non come benchmark da trasferire tale e quale nel proprio contesto.
## In pratica
1. Conserva le evidenze grezze delle investigazioni, con una retention definita: senza di esse non puoi testare nuove regole sul passato.
2. Scrivi l'elenco delle azioni che richiedono approvazione umana (blocchi, modifiche a sistemi critici, deploy) prima di automatizzare qualsiasi cosa.
3. Misura prima di automatizzare: ore dedicate per tipo di alert, percentuale di falsi positivi, tempo dalla segnalazione alla correzione. Senza un punto di partenza non saprai mai se l'agente ha migliorato le cose.
Se nel tuo team qualcuno sta già sperimentando agenti sui log o sugli alert, scrivi nei commenti quale flusso vorresti vedere automatizzato per primo. Se l'articolo ti è stato utile, condividilo con chi gestisce la sicurezza nella tua organizzazione.
Fonte: OpenAI, "Come Block costruisce la sicurezza basata sull'AI", 14 ottobre 2026: https://openai.com/index/block-ai-powered-security
sicurezza informatica, agenti AI, OpenAI, SOC, Daybreak